Estadística Correlacional

Inferencia, asociación, y reporte

Juan Carlos Castillo
Sociología FACSO - UChile
2do Sem 2026

correlacional.metodos-facso.org


Inferencia 3:

Intervalos de confianza y test de hipótesis (1)
¿Preguntas?

Hoy:


1. Intervalos de confianza

2. Test de hipótesis

Para comenzar: una historia sobre la confianza

Dos amigos y una hora de llegada

Quedamos de juntarnos mañana temprano, y a cada uno le preguntamos a qué hora llega:

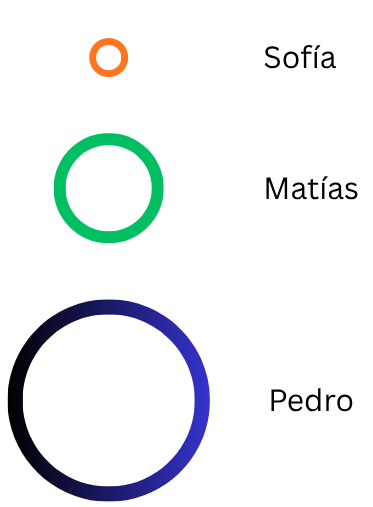
  • Sofía: “llego a las 8:00 en punto”

  • Matías: “llego entre las 7:50 y las 8:10”

¿A quién le creemos más?

¿Quién nos sirve más?

Una semana después

Día Llegó a las Sofía: “8:00 en punto” Matías: “entre 7:50 y 8:10”
lunes 8:07 ✗ ✓
martes 7:52 ✗ ✓
miércoles 8:09 ✗ ✓
jueves 8:21 ✗ ✗
viernes 7:58 ✗ ✓

Sofía acertó 0 de 5 veces; Matías, 4 de 5 (80%)

Primera moraleja

Una afirmación puntual suena muy bien, pero hay riesgo de que sea falsa

Una afirmación con rango es menos precisa, pero entrega más probabilidad de ser verdadera

  • Sofía no es mentirosa: es precisa hasta lo imposible

  • Matías no es impreciso necesariamente por flojera: puede estar reconociendo aquello que no controla (el tráfico, la micro, la alarma)

Pero aparece un tercer amigo…

  • Pedro: “llego entre las 6 de la mañana y las 12 del día”

Pedro nunca se va a equivocar: su rango va a acertar el 100% de las veces

… y su respuesta no nos sirve absolutamente de nada

Segunda moraleja: la confianza se paga con ancho

  • Podemos aumentar nuestra confianza tanto como queramos, pero ampliando el rango (Pedro)

  • Podemos ser tan precisos como queramos, pero perdiendo confianza (Sofía)

  • Ser confiable no es no equivocarse nunca: es declarar cuánto nos podemos equivocar (Matías)

De la historia a la estadística

En la historia En estadística
la hora exacta que promete Sofía el promedio de la muestra (estimación puntual)
el rango que promete Matías el intervalo de confianza
en qué proporción de los días el rango acierta el nivel de confianza (ej: 95%)
el ancho del rango (± 10 minutos) el margen de error
la hora real de llegada el parámetro de la población, que no conocemos

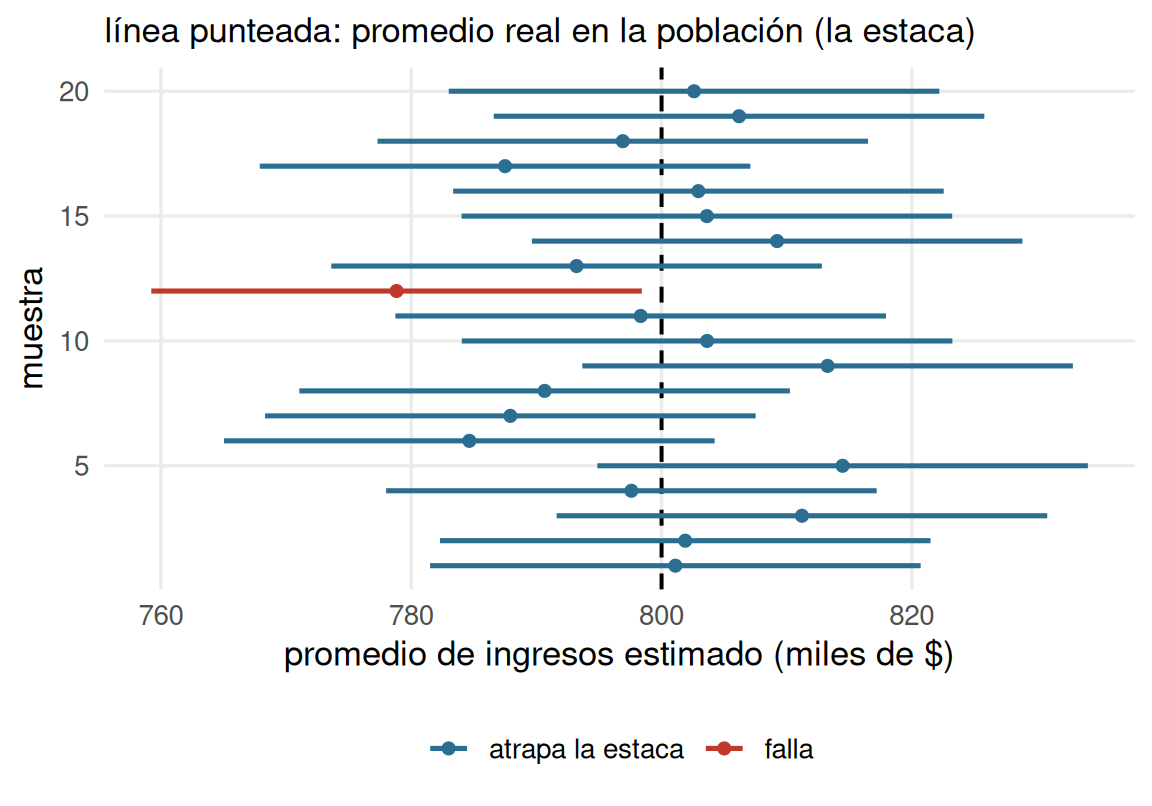
Una precisión importante: el aro y la estaca

  • En la historia, lo que cambiaba cada día era la hora de llegada

  • En estadística es al revés: el parámetro de la población está fijo (pero oculto), y lo que cambia de muestra en muestra es nuestro intervalo

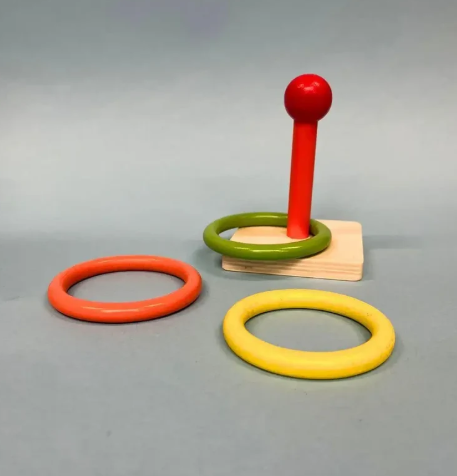
  • Es como lanzar un aro a una estaca que no vemos: la estaca no se mueve, lo que varía es el lanzamiento

Un 95% de confianza significa que 95 de cada 100 aros lanzados de esta manera atrapan la estaca

Nivel de confianza

  • en estadística inferencial, el nivel de confianza equivale a 1 - probabilidad de error

  • el nivel de probabilidad de error aceptado no es un criterio estadístico, es convencional

  • por convención, se acepta como estadísticamente significativa una probabilidad de error menor al 5%, lo que equivale (al menos) a un nivel de confianza del 95%

¿Qué significa un 95% de confianza?

  • que si tuviéramos la posibilidad de extraer múltiples muestras, el 95% de las veces nuestro intervalo contendría el promedio

  • o que existe un 5% de probabilidad de error, es decir, de que el promedio de la muestra no sea el de la población

  • o que las chances de error son 1 de 20

  • volviendo al ejemplo de los aros: que 95 de cada 100 aros que lancemos atrapan la estaca

Un intervalo de confianza (IC o CI) es la mejor estimación del rango de un estadístico en la población (parámetro poblacional) con una muestra aleatoria

Pasos en la construcción del intervalo de confianza (para un promedio)

  1. Obtención de la media y el error estándar

  2. Determinar el nivel de confianza (expresado en puntaje Z) para la construcción del intervalo

  3. Aplicar fórmula:

\[\bar{x}\pm Z*\frac{\sigma}{\sqrt{N}}\]

1. Media y error estándar

Ejemplo:

  • promedio de ingresos (media): 800.000
  • desviación estándar: 100.000
  • N muestral: 1.600

\[SE=\frac{s}{\sqrt{N}}=\frac{100.000}{\sqrt{1.600}}=\frac{100.000}{40}=2.500\]

  • Error estándar = 2.500

2. Establecer nivel de confianza

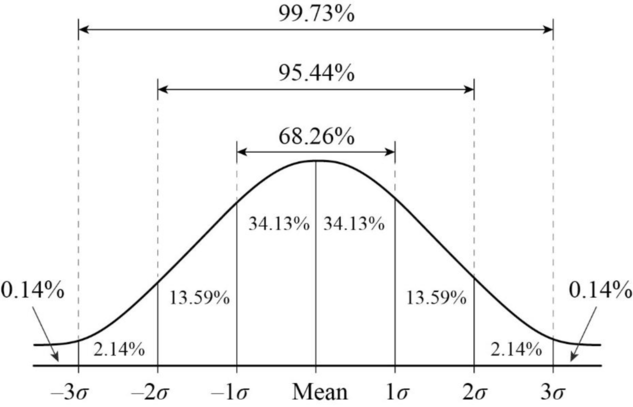
  • Nuestro promedio muestral \(\bar{x}\) posee una distribución normal con una desviación estándar = SE (error estándar)

  • Esto nos permite estimar probabilidades basados en los valores de la curva normal (puntaje Z)
Valores del intervalo

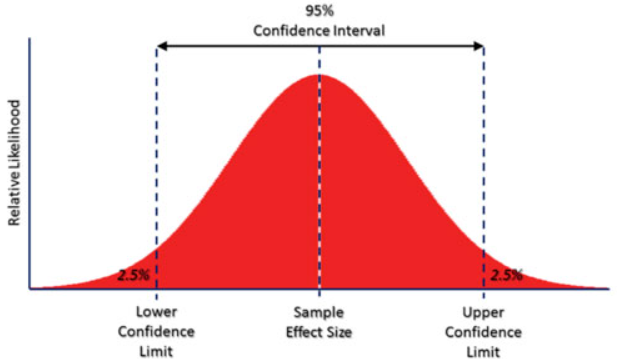
Determinar el valor del límite superior y el límite inferior del intervalo en la curva normal para un nivel de confianza del 95%:
Valores del intervalo

El límite inferior de un intervalo al 95% de confianza corresponde al percentil 2,5%, y el límite superior al 97,5% (95% + 2,5%)

Y sabemos por la distribución normal que entre +/- 2 desviaciones estándar de la curva normal se encuentra el 95,44% de los casos:

Por lo tanto, para un 95% será algo menos que +/- 2ds … pero cuánto específicamente?

De percentil a puntaje Z

  • Recordemos que al calcular el puntaje Z, el resultado se expresa en desviaciones estándar de la curva normal, lo que puede ser transformado a percentiles.

  • Por lo tanto, se puede hacer la operación inversa -> a qué puntaje Z corresponde un determinado percentil
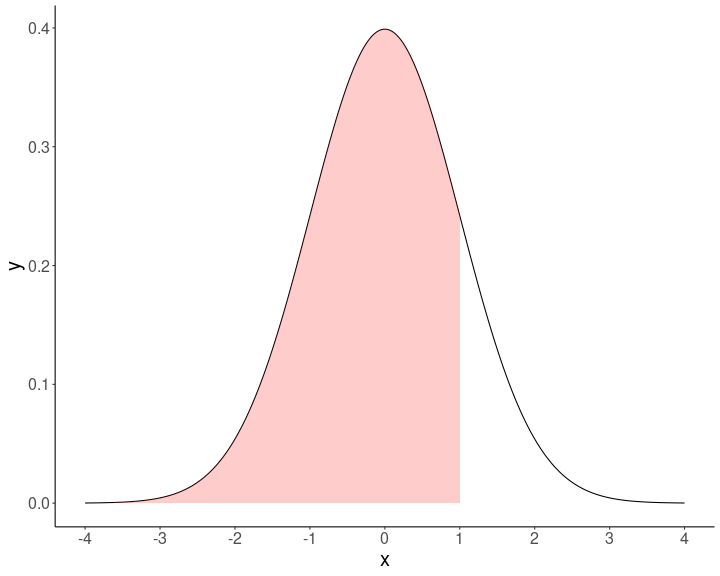
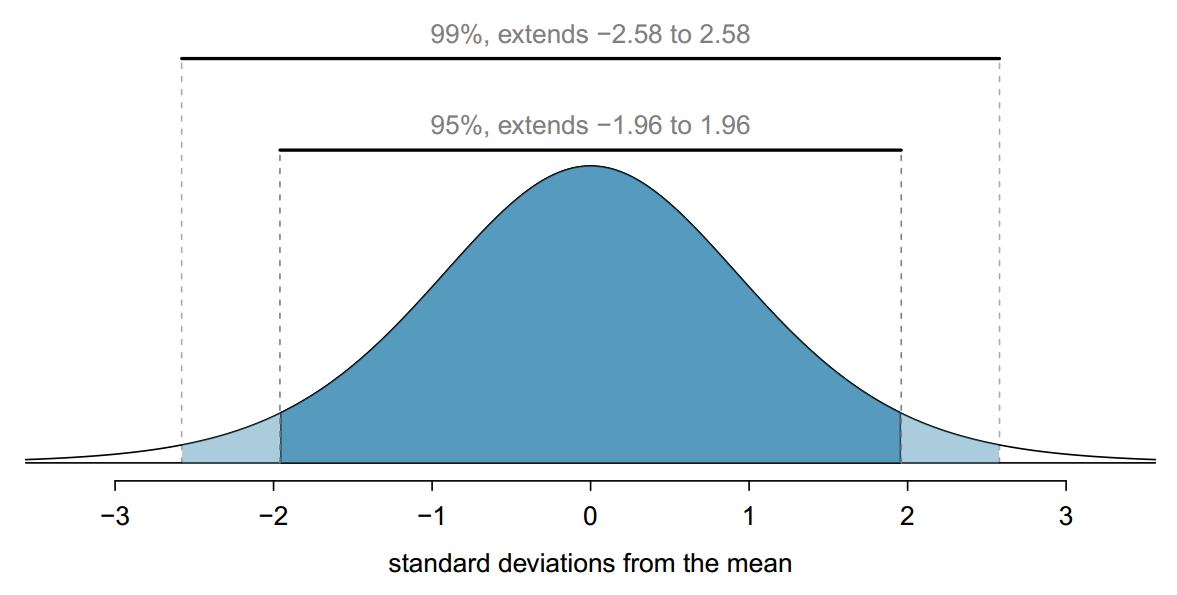
Para hacer la equivalencia entre puntajes Z y percentiles vamos a una tabla de puntajes Z … o directamente en R:

qnorm(0.025) # límite inferior
[1] -1.959964
qnorm(0.975) # límite superior
[1] 1.959964

Y aproximando: \(\pm{1.96}\)

3. Contrucción del intervalo

  • Sumando y restando 1.96 errores estándar al promedio construimos un intervalo de confianza del 95%

  • Volviendo al ejemplo inicial:

    • media: 800.000
    • error estándar: 2.500
    • nivel de confianza: 95% (Z=1.96)
    • intervalo: 800.000 ± 1.96*2.500 = 800.000 ± 4.900
    • límite inferior: 800.000 - 4.900 = 795.100
    • límite superior: 800.000 + 4.900 = 804.900
  • Por lo tanto, podemos decir con un 95% de confianza que el promedio de ingresos se encuentra entre 795.100 y 804.900 en la población

Aumentando el nivel de confianza: 99%

  • además del 95% de confianza, otro nivel convencional es el 99% de confianza

  • con este nivel tenemos una menor probabilidad de error, pero un intervalo más grande

  • en este caso, el límite inferior del intervalo es 0.5%, y el superior 99.5%

En R

Estimando valores Z para límites de intervalo de confianza al 99%:

qnorm(0.005) # límite inferior
[1] -2.575829
qnorm(0.995) # límite superior
[1] 2.575829
  • \(SE=2.500\), \(\bar{x}_{ingresos}=800.000\)
  • \(\bar{X}{\color{red}\pm}2.58SE\) abarcan el 99% de los valores alrededor del promedio
    • \(800.000 - (2.58*2.500) = 800.000 - 6.450={\color{red}{793.550}}\)
    • \(800.000 + (2.58*2.500) = 800.000 + 6.450={\color{red}{806.450}}\)
  • Por lo tanto, podemos decir con un 99% de confianza que el promedio de ingresos se encuentra entre 793.550 y 806.450

Comparando intervalos:

  • 95% de confianza: \(800.000\pm4.900=[795.100 - 804.900]\)

  • 99% de confianza: \(800.000\pm6.450=[793.550 - 806.450]\)

Por lo tanto, a mayor nivel de confianza, mayor es el intervalo, pero disminuye la precisión o aumenta el margen de error

Introducción a contraste de hipótesis

¿Existen diferencias salariales entre hombres y mujeres en Chile?

Hipótesis general Hipótesis estadística
Existen diferencias salariales entre hombres y mujeres Hipótesis alternativa: Las diferencias son distintas de cero
No existen diferencias salariales entre hombres y mujeres Hipótesis nula: Las diferencias no son distintas de cero

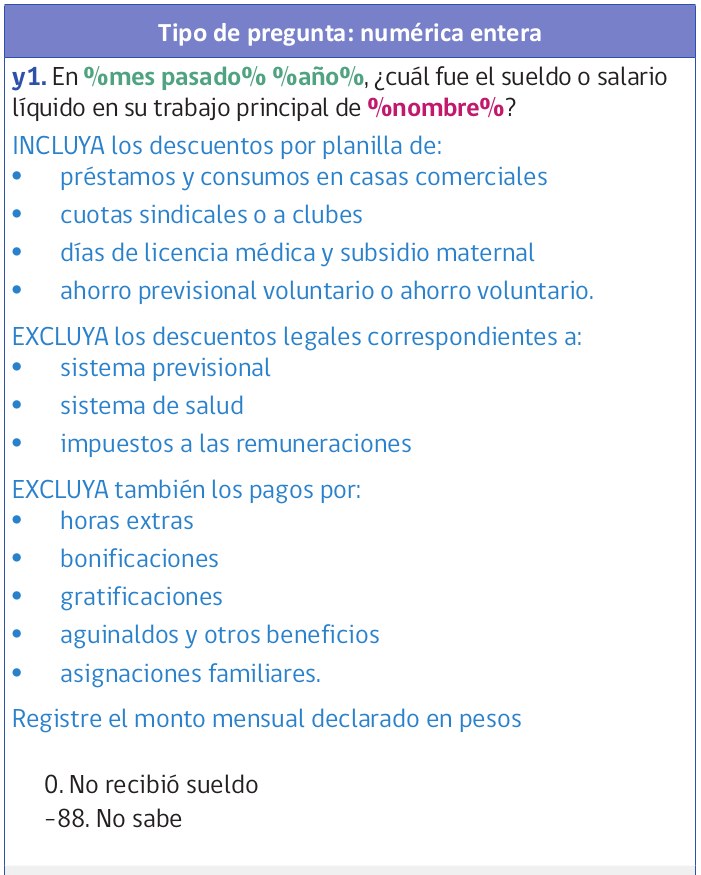
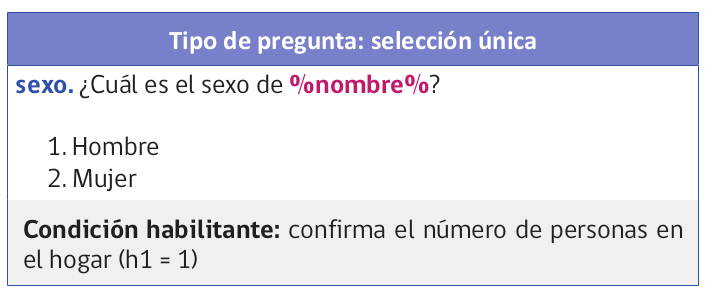
Cuestionario CASEN

Datos CASEN 2022
Vamos a generar una submuestra de 350 casos de CASEN para ilustrar de mejor manera el sentido del test de hipótesis

pacman::p_load(sjmisc, haven, dplyr, stargazer, interpretCI, kableExtra)
load("casen2022_inf2.Rdata")
options(scipen = 999) # para evitar notación en los ceros
set.seed(20) # para fijar el resultado aleatorio
casen_350 <- casen2022_inf %>% select(salario, sexo) %>% sample_n(350)
casen_350 <- na.omit(casen_350)
stargazer(as.data.frame(casen_350), type = "text")

======================================================
Statistic  N     Mean      St. Dev.    Min      Max   
------------------------------------------------------
salario   343 634,402.300 459,180.200 30,000 2,900,000
sexo      343    1.402       0.491      1        2    
------------------------------------------------------

casen_350 %>% # se especifica la base de datos
  dplyr::group_by(sexo = sjlabelled::as_label(sexo)) %>% # se agrupan por la variable categórica y se usan sus etiquetas con as_label
  dplyr::summarise(Obs. = n(), Promedio = mean(salario, na.rm = TRUE), SD = sd(salario, na.rm = TRUE)) %>% # se agregan las operaciones a presentar en la tabla
  kable(format = "markdown") # se genera la tabla
sexo Obs. Promedio SD
1. Hombre 205 654585.4 468692.5
2. Mujer 138 604420.3 444666.0
  • Diferencia salarial = 654.585-604.420=50.165

¿Es esta diferencia estadísticamente significativa?

Procedimiento: 5 pasos de la inferencia (ajustados de Ritchey)

  1. Formular hipótesis ( \(H_0\) y \(H_A\))

  2. Obtener error estándar y estadístico de prueba empírico correspondiente (ej: Z o t)

  3. Establecer la probabilidad de error \(\alpha\) (usualmente 0.05) y obtener valor crítico (teórico) de la prueba correspondiente

  4. Cálculo de intervalo de confianza / contraste valores empírico/crítico

  5. Interpretación

1. Formulación de hipótesis

Una hipótesis es una aseveración o una predicción que se desprende de una teoría sobre una situación que ocurre en la población en estudio

¿Cuándo se puede verificar una hipótesis?


NUNCA


… pero, se puede falsar

Contraste de hipótesis y falsación

  • El verificar una hipótesis no hace que una teoría sea verdadera

  • Se puede intentar refutar una teoría (falsarla) mediante un contraejemplo o hipótesis contraria

  • Si no es posible refutar la hipótesis contraria, entonces la teoría queda aceptada provisionalmente

Lógica de contraste de hipótesis

Intentar falsar lo que es contrario a nuestra hipótesis original

En estadística, esta “hipótesis contraria” se denomina la HIPÓTESIS NULA

Formulando hipótesis

Contrastamos la hipótesis nula (no hay diferencias de promedios entre grupos):

\[H_{0}: \bar{X}_{hombres} - \bar{X}_{mujeres}= 0\]

En referencia a la siguiente hipótesis alternativa:

\[H_{a}: \bar{X}_{hombres} - \bar{X}_{mujeres} \neq 0\]

2. Error estándar y estadístico de prueba

  • El error estándar de la diferencia de promedios usa una fórmula distinta al del promedio (detalles próxima clase).

  • Por ahora, lo vamos a dejar expresado así:

\[SE=\sqrt{\frac{\sigma_{diff}}{n_a}+\frac{\sigma_{diff}}{n_b}}=50561\]

3. Establecer probabilidad de error

  • Como ya sabemos, de manera convencional: \(\alpha=0.05\)

4. Intervalo de confianza

  • de la clase anterior con prueba Z sabemos que el valor crítico para un 95% de confianza es 1.96

  • para diferencia de medias se utiliza prueba \(t\), donde el valor crítico es variable según en tamaño muestral

  • sin embargo, para muestras grandes, t=Z, y por lo tanto por ahora mantendremos los valores referenciales Z (de 1.96) hasta que profundicemos en t la próxima clase

4. Intervalo de confianza

\[ \begin{align*} \bar{x}_1-\bar{x}_2 &\pm t_{\alpha/2}*SE_{\bar{x_1}-\bar{x_2}} \\\\ 50165 &\pm 1.96*50561 \\\\ 50165 &\pm 99099.56 \\\\ CI[-49287.48&;149617.63] \end{align*} \]

5. Interpretación

Nuestro intervalo de confianza contiene el cero, por lo que no se rechaza la hipótesis nula

Con un 95% de confianza (5% de probabilidad de error) no se encuentra evidencia de diferencias salariales entre hombres y mujeres.

Alternativamente: No existe evidencia que las diferencias salariales entre hombres y mujeres son distintas de cero, con un 5% de probabilidad de error

Resumen

  • Intervalos de confianza, precisión y error
  • Hipótesis y falsación
  • Generación de intervalos para contrastar hipótesis
  • Si el intervalo contiene el 0, no se logra rechazar \(H_0\)


Estadística Correlacional

Inferencia, asociación, y reporte

Juan Carlos Castillo
Sociología FACSO - UChile
2do Sem 2026

correlacional.metodos-facso.org