
Inferencia, asociación, y reporte
Juan Carlos Castillo
Sociología FACSO - UChile
2do Sem 2026
correlacional.metodos-facso.org
Inferencia 4:
Falsación, tipos de error y prueba t
PROBABILIDADES … de un rango de valores

Podemos calcular probabilidades basados en una distribución teórica de ocurrencia de eventos.
Ej: En teoría, la probabilidad de que salga sello al tirar una moneda es 50%
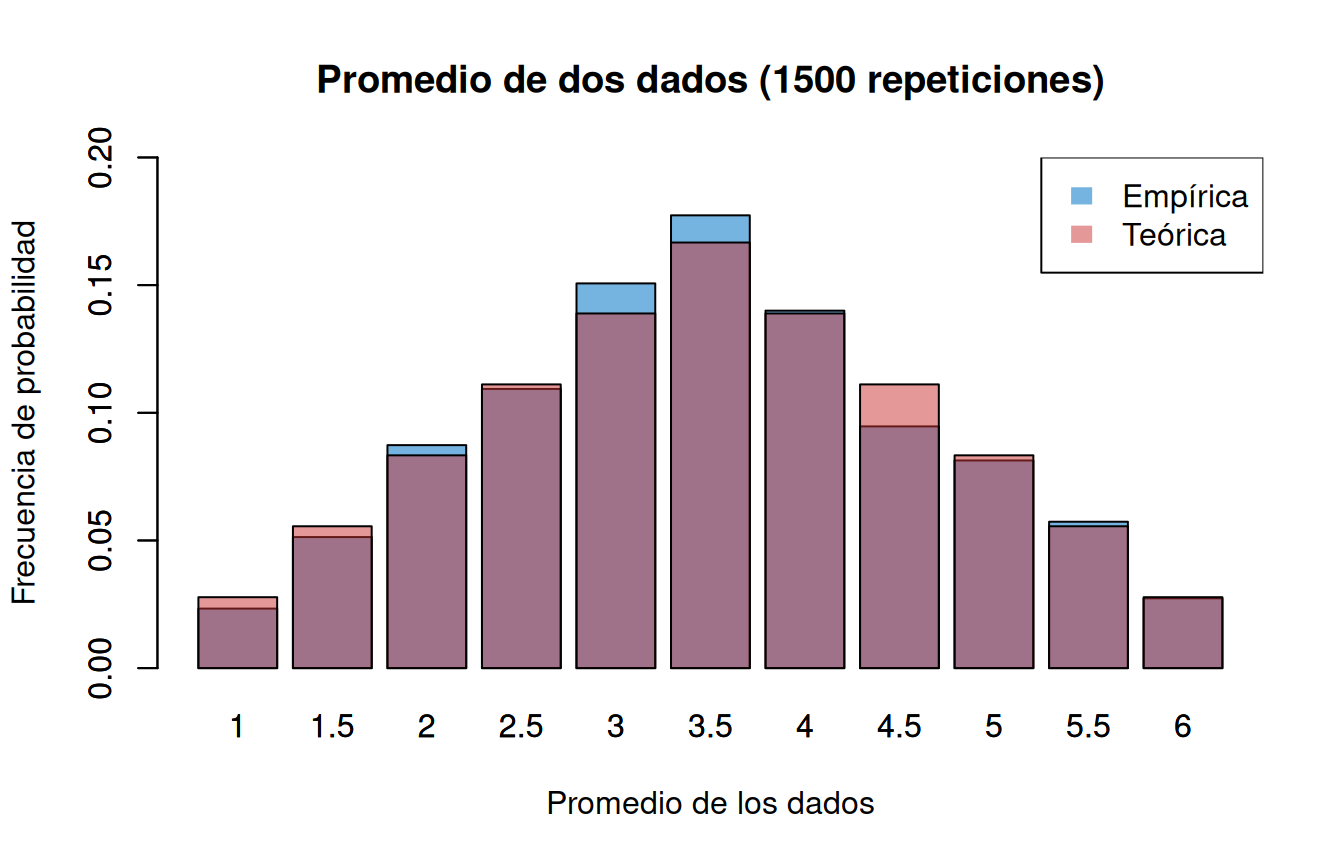
Mientras más repetimos el evento, más se van a acercar los resultados (distribución empírica) a la probabilidad del evento (distribución teórica)

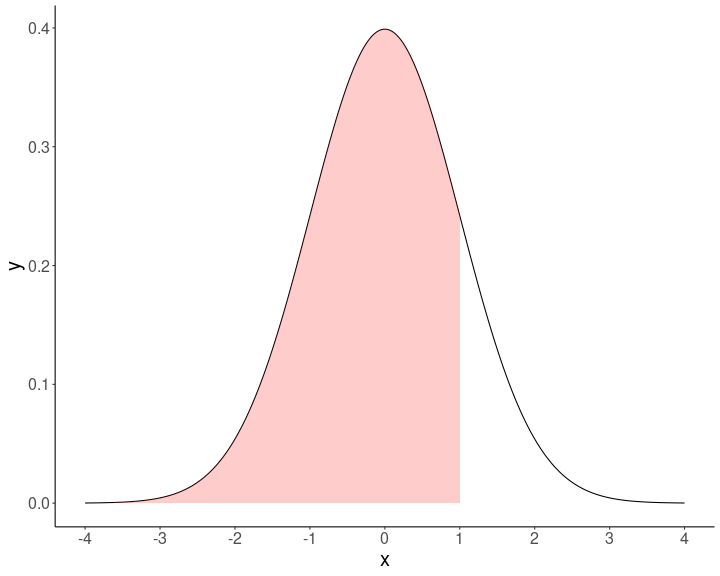
Hay una serie de eventos que en términos teóricos y empíricos tienen una distribución particular en torno al valor central -> normal
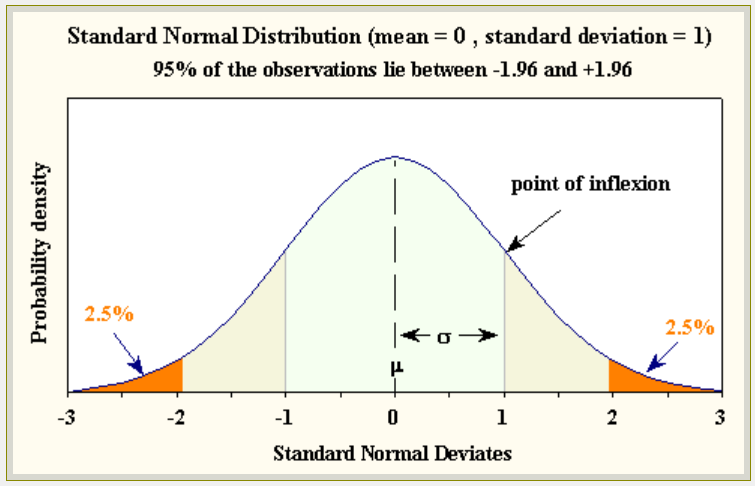
La curva normal es una distribución teórica que nos permite tener un estándar con el cual comparar distribuciones empíricas

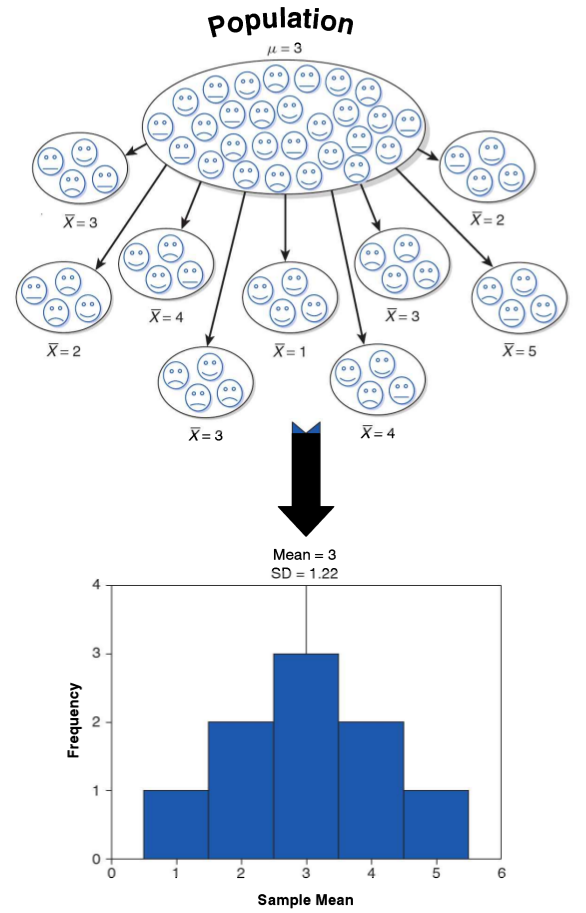
si pudiera calcular un estadístico en muchas muestras distintas (ej: promedio) este se distribuiría de manera normal
el error estándar es la formula que nos permite obtener el valor de la desviación estándar de los promedios con una sola muestra
\[\sigma_{\bar{X}}=\frac{s}{\sqrt{N}}\]
el puntaje Z es una transformación a una métrica de desviaciones estándar del promedio
asumiendo distribución normal, el puntaje Z permite además obtener el valor del percentil de cada puntaje
\[z=\frac{x-\mu}{\sigma}\]

rango de probabilidad del valor de un parámetro en la población
Para construirlo, 4 pasos:
1- establecer nivel de confianza (convencionalmente 95%)
2- definir puntaje Z correspondiente a este intervalo (para 95% es 1.96)
3- multiplicar Z por el error estándar
4- restar al promedio (límite inferior) y sumar (límite superior)
\[\bar{X}\pm Z*\frac{\sigma}{\sqrt{N}}\]

“el criterio de demarcación que hemos de adoptar no es el de la verificabilidad, sino el de la falsabilidad de los sistemas. Dicho de otro modo: no exigiré que un sistema científico pueda ser seleccionado, de una vez para siempre, en un sentido positivo; pero sí que sea susceptible de selección en un sentido negativo por medio de contrastes o pruebas empíricas: ha de ser posible refutar por la experiencia un sistema científico empírico” (Popper, 1982, p. 40)

El verificar una hipótesis no hace que una teoría sea verdadera
Se puede intentar refutar una teoría (falsarla) mediante un contraejemplo o hipótesis contraria
Si no es posible refutar la hipótesis contraria, entonces la teoría queda aceptada provisionalmente
Teoría: todos los cuervos son negros
Hipótesis de verificación: hay cuervos negros
Hipótesis de falsación: hay cuervos blancos
si logramos rechazar la hipótesis nula (o sea, que lo contrario de nuestra teoría no es verdad), entonces encontramos evidencia a favor de nuestra teoría
Buscamos NO ENCONTRAR cuervos blancos 
Hipótesis se denota con la letra \(H\)
La hipótesis nula se denota \(H_0\) (hache cero)
Cero porque en general se refiere a que lo que señala la teoría no existe o es cero en la población
¿Existen diferencias salariales entre hombres y mujeres en Chile?
| Hipótesis general | Hipótesis estadística |
|---|---|
| Existen diferencias salariales entre hombres y mujeres | Hipótesis alternativa: Las diferencias son distintas de cero |
| No existen diferencias salariales entre hombres y mujeres | Hipótesis nula: Las diferencias no son distintas de cero |


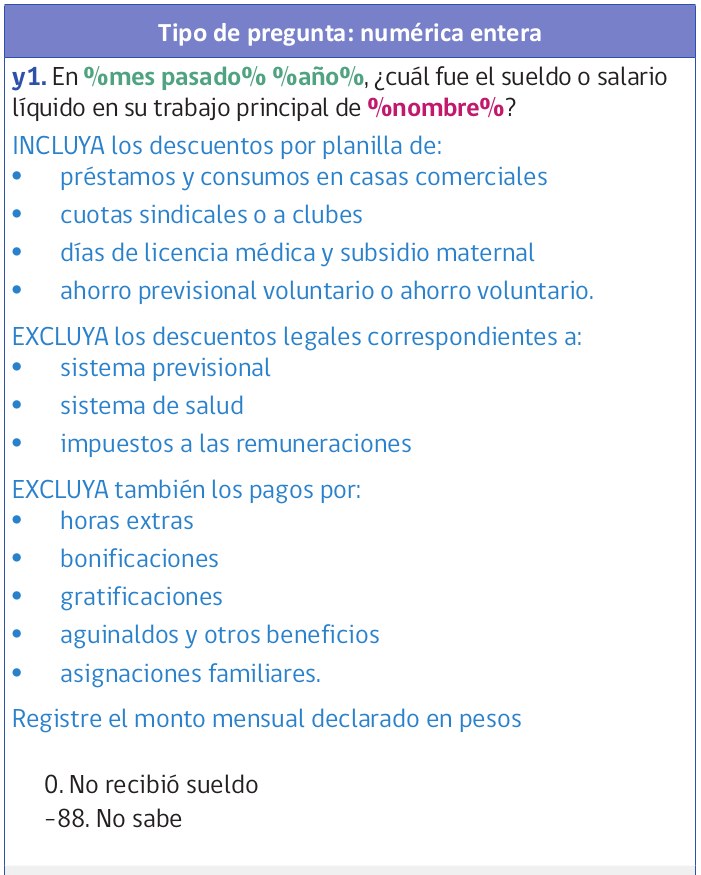
Vamos a generar una submuestra de 350 casos de CASEN para ilustrar de mejor manera el sentido del test de hipótesis
pacman::p_load(sjmisc, haven, dplyr, stargazer, interpretCI, kableExtra)
load("casen2022_inf2.Rdata")
options(scipen = 999) # para evitar notación en los ceros
set.seed(20) # para fijar el resultado aleatorio
casen_350 <- casen2022_inf %>% select(salario, sexo) %>% sample_n(350)
casen_350 <- na.omit(casen_350)
======================================================
Statistic N Mean St. Dev. Min Max
------------------------------------------------------
salario 343 634,402.300 459,180.200 30,000 2,900,000
sexo 343 1.402 0.491 1 2
------------------------------------------------------
casen_350 %>% # se especifica la base de datos
dplyr::group_by(sexo = sjlabelled::as_label(sexo)) %>% # se agrupan por la variable categórica y se usan sus etiquetas con as_label
dplyr::summarise(Obs. = n(), Promedio = mean(salario, na.rm = TRUE), SD = sd(salario, na.rm = TRUE)) %>% # se agregan las operaciones a presentar en la tabla
kable(format = "markdown") # se genera la tabla| sexo | Obs. | Promedio | SD |
|---|---|---|---|
| 1. Hombre | 205 | 654585.4 | 468692.5 |
| 2. Mujer | 138 | 604420.3 | 444666.0 |
Diferencia salarial = 654.585-604.420=50.165
Formular hipótesis ( \(H_0\) y \(H_A\))
Estadístico de prueba empírico (ej: Z o t)
Establecer la probabilidad de error \(\alpha\) (usualmente 0.05) y obtener valor crítico (teórico) de la prueba correspondiente
Cálculo de intervalo de confianza / contraste valores empírico/crítico
Interpretación
Contrastamos la hipótesis nula (no hay diferencias de promedios entre grupos):
\[H_{0}: \bar{X}_{hombres} - \bar{X}_{mujeres}= 0\]
En referencia a la siguiente hipótesis alternativa:
\[H_{a}: \bar{X}_{hombres} - \bar{X}_{mujeres} \neq 0\]
\[t=\frac{\bar{X}_{hombres}-\bar{X}_{mujeres}}{SE}\]
Important
En general el estadístico de prueba es la magnitud de interés (en este caso, la diferencia de medias) dividido por el error estándar. Por lo tanto, su resultado nos dice cuántos errores estándar hay entre la diferencia de medias empírica y la diferencia de medias teórica (que es 0, según \(H_0\))
Cada estadístico tiene su propia fórmula de error estándar
En el caso de la diferencia de medias (en este caso, de hombres y mujeres), el error estándar es:
\[SE=\sqrt{\frac{\sigma_{diff}}{n_a}+\frac{\sigma_{diff}}{n_b}}\]
Donde
\[\sigma_{diff}=\frac{\sigma^2_{a}(n_a-1)+\sigma^2_{b}(n_b-1)}{n_a+n_b-2}\]
Cálculo de la desviación estándar de las diferencias de promedios:
\[ \begin{align*} \sigma_{diff}&=\frac{468692^2(205-1)+444666^2(138-1)}{205+138-2} \\ \\ &=\frac{44813126936256+27088715663172}{341}\\ \\ &=210855843400 \end{align*} \]
Y entonces el error estándar de la diferencia de medias:
\[ \begin{align*} SE&=\sqrt{\frac{\sigma_{diff}}{n_a}+\frac{\sigma_{diff}}{n_b}} \\ \\ &=\sqrt{\frac{210855843400}{205}+\frac{210855843400}{138}}\\ \\ &=50561 \end{align*} \]
\[t=\frac{\bar{X}_{hombres}-\bar{X}_{mujeres}}{SE}=\frac{50165}{50561}=0.9904\]
El valor de \(t\) obtenido de 0.9904(empírico) nos permite contrastar la diferencia de medias empírica con la diferencia de medias teórica (que es 0, según \(H_0\)).
Por lo tanto, la pregunta es: ¿es 0.9904 un valor suficientemente grande para rechazar la hipótesis nula?
Para poder responder esto, necesitamos establecer un nivel de confianza/probabilidad de error
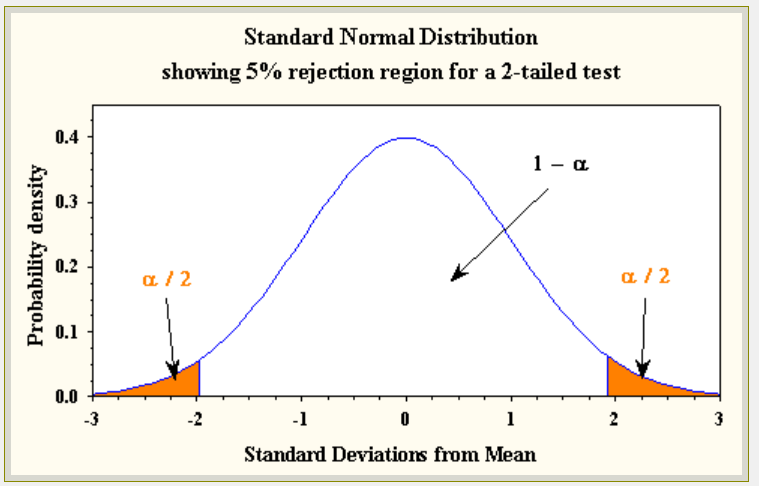
asumimos que existe una probabilidad de error al rechazar \(H_0\), para lo cual fijamos un límite convencional -> usualmente un 5%
¿error de qué? -> de rechazar \(H_0\) cuando esta existe en la población.
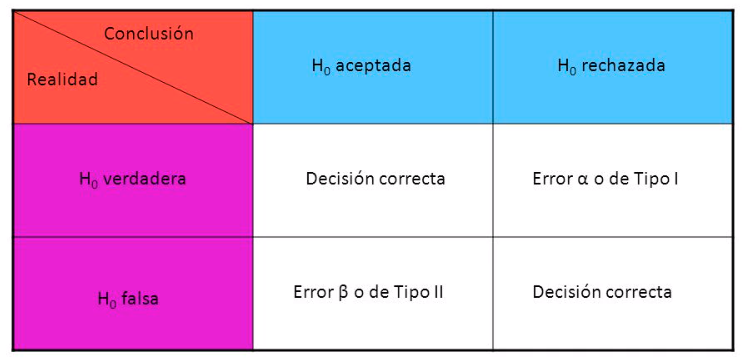
Esto se conoce como la probabilidad de error Tipo I o \(\alpha\) (alfa)
\[H_{0}: \bar{X}_{sueldo\ mujeres} - \bar{X}_{sueldo\ hombres}= 0\]
Si hay diferencias de sueldo en la población y rechazamos \(H_0\): decisión correcta
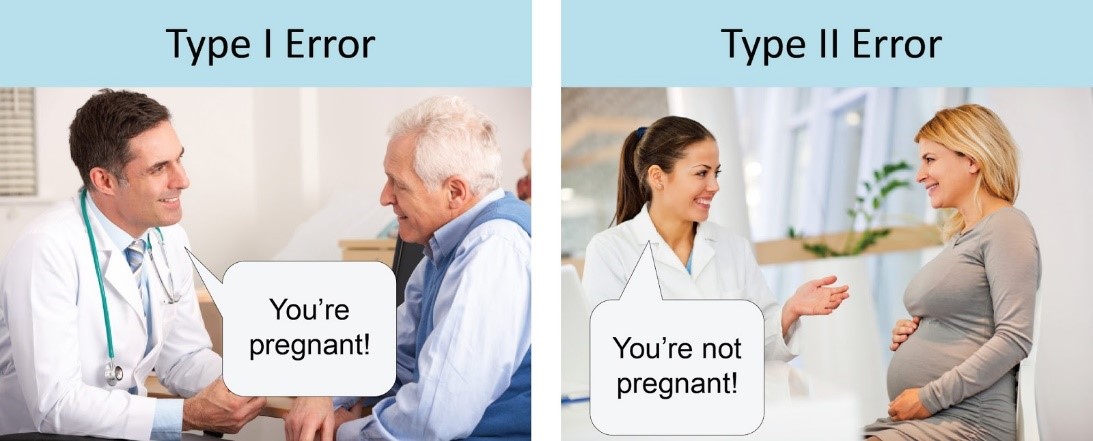
Si no hay diferencias de sueldo en la población y rechazamos \(H_0\): Error tipo I
El Error Tipo I equivale a encontrar cosas en nuestra muestra que no existen en la población
Encontrar algo que no existe en la población
No encontrar algo que si existe en la población
Entonces, el \(\alpha\) es la probabilidad de error que fijamos para rechazar la hipótesis nula
en lenguaje de prueba de hipótesis, es la probabilidad de rechazar la hipótesis nula cuando esta es verdadera
o la probabilidad de encontrar diferencias entre grupos de la población cuando estas no existen
o en simple, la probabilidad de que nos estemos equivocando
el nivel de confianza de una estimación se determina de manera convencional, usualmente se acepta 95% o 99% de confianza
un nivel de confianza se expresa en una probabilidad de error \(\alpha\) (alfa), que es 1 - nivel de confianza
para un nivel de confianza de 95%, \(\alpha=1-0.95=0.05\)
para un nivel de confianza de 99%, \(\alpha=1-0.99=0.01\)
En el paso 2 calculamos el t empírico. En este paso calcularemos el t crítico
Si el t empírico es mayor que el t crítico, entonces rechazamos la hipótesis nula
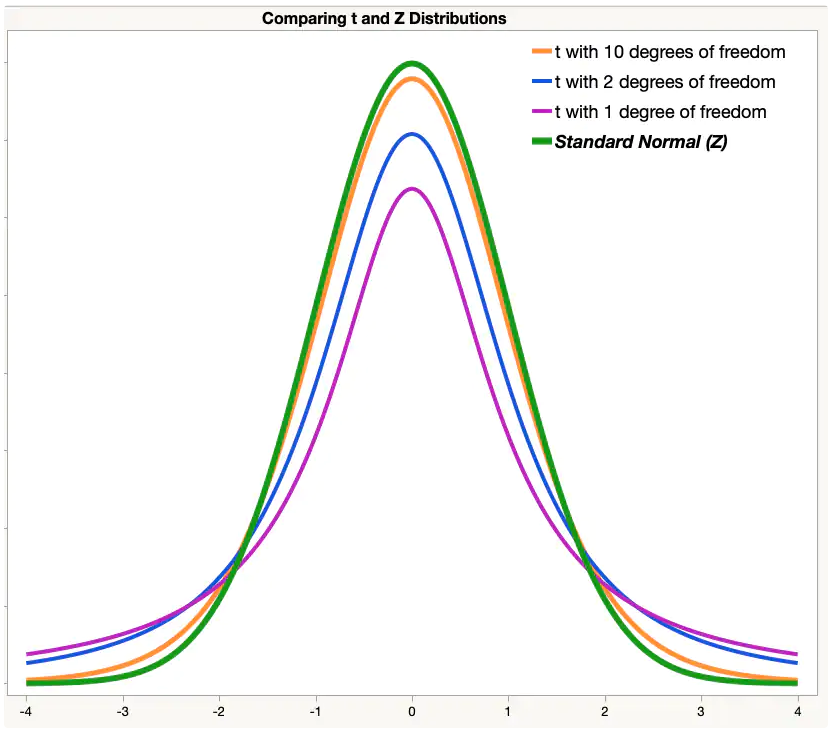
a diferencia de la prueba Z (donde los valores son fijos), el los valores críticos de t dependen del tamaño muestral
el tamaño muestral determina los grados de libertad (df) de la prueba t, que se calculan como \(df=n_1+n_2-2\) (es decir, es el tamaño de la muestra menos 2)
\[df=n_1+n_2-2=205+138-2=341\]
Lo que corresponde a un valor crítico de \(t_{0.975}=1.96\) (para un nivel de confianza de 95%)
Esto se puede obtener en R con la función qt():
Important
El valor crítico de t se aproxima al valor crítico de Z cuando el tamaño muestral es grande (usualmente n>30)
Ahora podemos calcular el intervalo de confianza para la diferencia de medias:
\[ \begin{align*} \bar{x}_1-\bar{x}_2 &\pm t_{\alpha/2}*SE_{\bar{x_1}-\bar{x_2}} \\\\ 50165 &\pm 1.96*50561 \\\\ 50165 &\pm 99099.56 \\\\ CI[-49287.48&;149617.63] \end{align*} \]
Two Sample t-test
data: salario by sexo
t = 0.99215, df = 341, p-value = 0.3218
alternative hypothesis: true difference in means between group 1 and group 2 is not equal to 0
95 percent confidence interval:
-49287.48 149617.63
sample estimates:
mean in group 1 mean in group 2
654585.4 604420.3
\[ t_{\text{emp}}=0.9904 > t_{\text{crít}}=1.96 \Rightarrow \text{rechazamos } H_0 \]
Con un 95% de confianza (5% de probabilidad de error) no se encuentra evidencia de diferencias salariales entre hombres y mujeres.
Alternativamente: No existe evidencia que las diferencias salariales entre hombres y mujeres sean distintas de cero, con un 5% de probabilidad de error
hipótesis: aseveraciones sobre algo que ocurre en la población, usualmente asociaciones entre conceptos / variables
las hipótesis se contrastan con un criterio de falsabilidad: se trata de falsar/rechazar la Hipótesis nula (H0)
para rechazar necesitamos un estadístico de prueba empírico, que se contrasta con un valor crítico (teórico) de rechazo según una probabilidad de error \(\alpha\)
para la diferencia de medias, el estadístico de prueba es t

Inferencia, asociación, y reporte
Juan Carlos Castillo
Sociología FACSO - UChile
2do Sem 2026